Ketika perusahaan mulai menjalankan AI secara serius, salah satu pertanyaan pertama yang muncul biasanya: GPU apa yang harus digunakan?
Pertanyaan tersebut penting, tetapi belum lengkap.
Enterprise chatbot, computer vision, predictive analytics, generative AI, hingga model training sama-sama membutuhkan compute, tetapi karakter workload-nya dapat sangat berbeda. GPU yang ideal untuk satu aplikasi belum tentu efisien untuk aplikasi lainnya.
Karena itu, perusahaan yang sedang mencari GPU Cloud Indonesia sebaiknya tidak memulai dari GPU dengan spesifikasi tertinggi. Mulailah dari workload, kebutuhan aplikasi, data, jumlah pengguna, dan target performa.
Dari sana, barulah GPU dan arsitektur yang tepat dapat ditentukan.
Mengapa Perusahaan Mulai Mencari GPU Cloud?
Membeli GPU sendiri bukan satu-satunya cara membangun AI.
Untuk perusahaan yang masih melakukan proof of concept (PoC), kebutuhan compute dapat berubah dengan cepat. Model bisa berganti, dataset bertambah, dan requirement production belum sepenuhnya diketahui.
GPU cloud memberi ruang untuk melakukan eksperimen dan validasi terlebih dahulu sebelum perusahaan menentukan kapasitas jangka panjang.
Beberapa workload yang umum dijalankan menggunakan cloud GPU antara lain:
- enterprise chatbot dan RAG;
- LLM inference dan fine-tuning;
- document intelligence;
- computer vision;
- predictive analytics;
- generative AI;
- rendering dan visual computing;
- model training dan AI development.
Namun kebutuhan GPU untuk masing-masing workload tersebut tidak sama.
Sebelum Memilih GPU, Kenali Workload Anda
Pemilihan GPU sebaiknya dimulai dari beberapa pertanyaan sederhana.
Training atau inference?
Training membutuhkan compute besar untuk melatih atau melakukan fine-tuning model.
Inference terjadi ketika model yang sudah tersedia digunakan untuk memproses request—misalnya ketika user bertanya kepada chatbot atau aplikasi menjalankan image recognition.
Keduanya membutuhkan pendekatan sizing yang berbeda.
Model apa yang akan digunakan?
Ukuran model sangat memengaruhi kebutuhan GPU memory.
Menjalankan model kecil untuk klasifikasi dokumen tentu berbeda dengan menjalankan large language model dengan context window besar dan banyak concurrent users.
Karena itu, informasi seperti model, parameter size, precision, quantization, dan context length membantu menentukan kandidat GPU lebih tepat.
Berapa banyak user yang akan mengakses?
PoC untuk sepuluh pengguna berbeda dengan aplikasi AI yang digunakan ratusan orang secara bersamaan.
Dalam production, parameter seperti concurrency, throughput, response time, serta GPU utilization sering lebih penting dibanding sekadar memastikan model berhasil dijalankan.
Lokasi GPU Juga Perlu Dipertimbangkan
Bagi perusahaan di Indonesia, lokasi infrastructure dapat menjadi salah satu faktor ketika AI terhubung dengan aplikasi, pengguna, atau sumber data lokal.
Misalnya chatbot perusahaan yang mengakses knowledge base internal, computer vision dari fasilitas di Indonesia, atau inference API yang digunakan aplikasi lokal.
Infrastructure yang berada lebih dekat dapat membantu mengurangi jarak jaringan, tetapi lokasi bukan satu-satunya penentu latency. Model, network, architecture, application design, dan workload tetap berpengaruh.
Data residency juga perlu dinilai sebagai bagian dari keseluruhan desain governance dan security, bukan hanya lokasi server.
Karena itu, cloud GPU lokal idealnya dilihat sebagai bagian dari keputusan arsitektur yang lebih luas.
GPU Compute atau GPU Kubernetes?
Tidak semua AI workload harus langsung menggunakan Kubernetes.
GPU Compute
GPU Compute cocok untuk kebutuhan seperti:
- PoC;
- AI development;
- notebook;
- single-model inference;
- model training;
- workload yang belum membutuhkan orchestration kompleks.
Tim dapat menjalankan model, melakukan benchmark, lalu melihat apakah GPU tersebut sesuai dengan workload aktual.
GPU Kubernetes
Kubernetes menjadi lebih relevan ketika AI berkembang menjadi platform yang terdiri dari beberapa service.
Misalnya perusahaan mulai menjalankan inference API, multiple model, embedding service, preprocessing, vector database, model serving, dan microservices secara bersamaan.
Civo menyediakan GPU melalui traditional compute maupun managed Kubernetes sehingga perusahaan dapat memilih deployment model berdasarkan tingkat kompleksitas workload. (Civo)
Ini penting karena kebutuhan ketika melakukan PoC belum tentu sama dengan kebutuhan setelah aplikasi masuk production.
Jangan Memilih GPU Hanya dari Nama Model
Portfolio NVIDIA GPU saat ini cukup luas.
A100 dapat digunakan untuk berbagai workload AI dan data analytics. L40S menarik untuk kombinasi AI dan visual computing. H100 banyak digunakan untuk intensive AI, LLM dan generative workloads, sementara H200 menyediakan memory lebih besar untuk workload yang semakin memory-intensive. Generasi Blackwell seperti B200 dan B300 diarahkan ke AI workload dengan skala semakin tinggi. (Civo)
Namun GPU terbaru bukan otomatis pilihan terbaik.
GPU yang lebih besar tetapi hanya terpakai sebagian dapat menghasilkan infrastructure cost yang kurang efisien.
Pendekatan yang lebih sehat adalah:
Workload → GPU Candidate → Benchmark → Cost → Production
Dengan pola tersebut, perusahaan dapat membandingkan bukan hanya harga GPU per jam tetapi biaya untuk menghasilkan performa yang dibutuhkan.
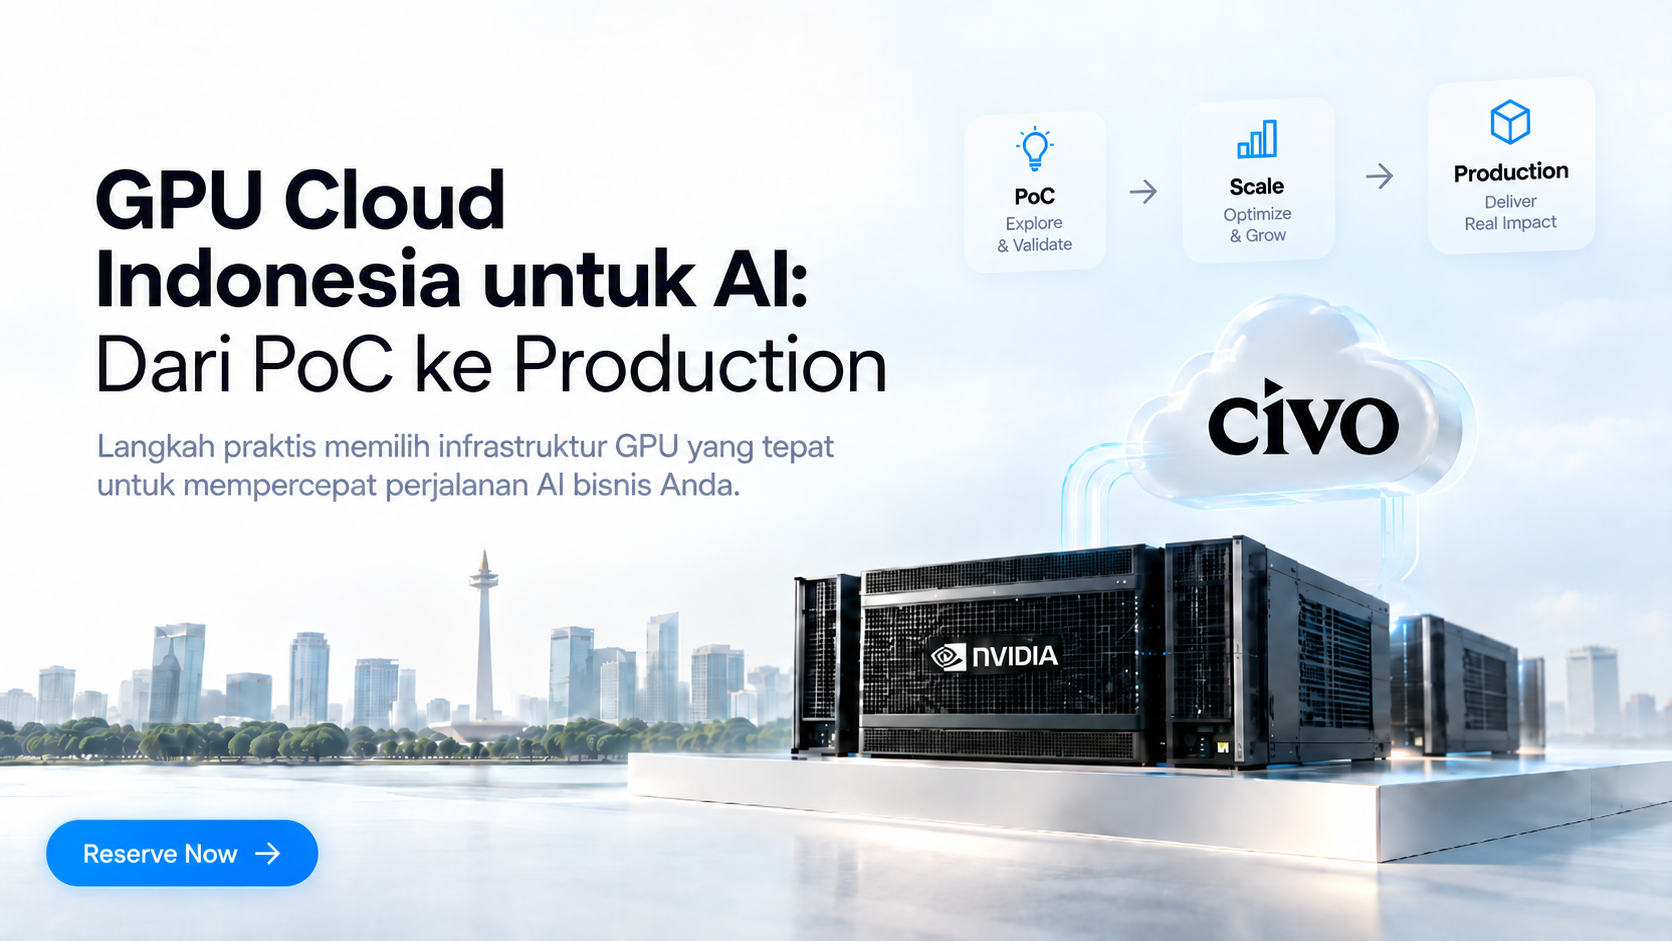
Dari PoC Menuju Production
Implementasi AI tidak harus langsung dimulai dengan infrastructure besar.
Pendekatan bertahap justru memberi perusahaan lebih banyak data untuk mengambil keputusan.
1. Workload Assessment
Tentukan use case, model, dataset, jumlah user, concurrency, latency target, security, lokasi data, dan target bisnis.
2. GPU & Architecture Sizing
Pilih kandidat GPU dan deployment model yang sesuai, termasuk compute, storage, networking, serta apakah Kubernetes diperlukan.
3. PoC & Benchmark
Jalankan workload nyata dan ukur response time, throughput, GPU utilization, compatibility, serta biaya.
4. Production & Optimization
Setelah hasil PoC memenuhi target, barulah kapasitas diperbesar. Monitoring kemudian digunakan untuk melihat apakah resource masih sesuai ketika traffic dan model berubah.
Dengan proses ini, keputusan infrastructure didasarkan pada hasil pengukuran, bukan asumsi.
Civo AI dan GPU Cloud untuk Indonesia
Civo menggabungkan GPU compute dengan cloud-native infrastructure dan managed Kubernetes untuk berbagai AI/ML workload. Portfolio GPU global Civo mencakup beberapa generasi NVIDIA GPU, mulai dari A100 dan L40S hingga H100, H200, B200 dan B300. (Civo)
Untuk pasar Indonesia, Arupa juga menyiapkan NVIDIA RTX PRO 6000 Blackwell dan NVIDIA B300 sebagai upcoming GPU di Civo Region Jakarta. Ketersediaan, konfigurasi, kapasitas, dan timeline aktual perlu dikonfirmasi pada saat assessment. (Arupa Cloud Nusantara).
Mulai dari Workload, Bukan dari GPU
Pertanyaan terbaik bukan:
“GPU mana yang paling powerful?”
Tetapi:
“GPU dan arsitektur mana yang paling sesuai untuk workload kami?”
Jika perusahaan Anda sedang mengevaluasi GPU Cloud Indonesia untuk LLM, enterprise chatbot, RAG, computer vision, generative AI, analytics, atau AI platform, mulailah dengan memetakan workload terlebih dahulu.
Assessment Workload AI Anda
Ceritakan use case, model, jumlah pengguna, target performa, dan kebutuhan data Anda. Tim Arupa dapat membantu memetakan GPU dan arsitektur Civo yang sesuai sebelum PoC maupun production deployment.
FAQ
Apa itu GPU Cloud?
GPU Cloud adalah layanan cloud yang menyediakan akses ke GPU untuk workload seperti AI, machine learning, inference, training, computer vision, rendering, dan high-performance computing tanpa harus membeli hardware GPU sendiri.
Apakah semua workload AI membutuhkan GPU?
Tidak. Workload ringan tertentu masih dapat berjalan menggunakan CPU. GPU menjadi semakin relevan ketika aplikasi membutuhkan parallel computing tinggi, model yang lebih besar, atau throughput inference yang tinggi.
Apakah harus menggunakan Kubernetes untuk menjalankan AI?
Tidak. GPU Compute dapat digunakan untuk PoC maupun single workload. Kubernetes menjadi lebih relevan ketika dibutuhkan orchestration, multi-model deployment, autoscaling, MLOps, atau architecture berbasis microservices.
Comments are closed