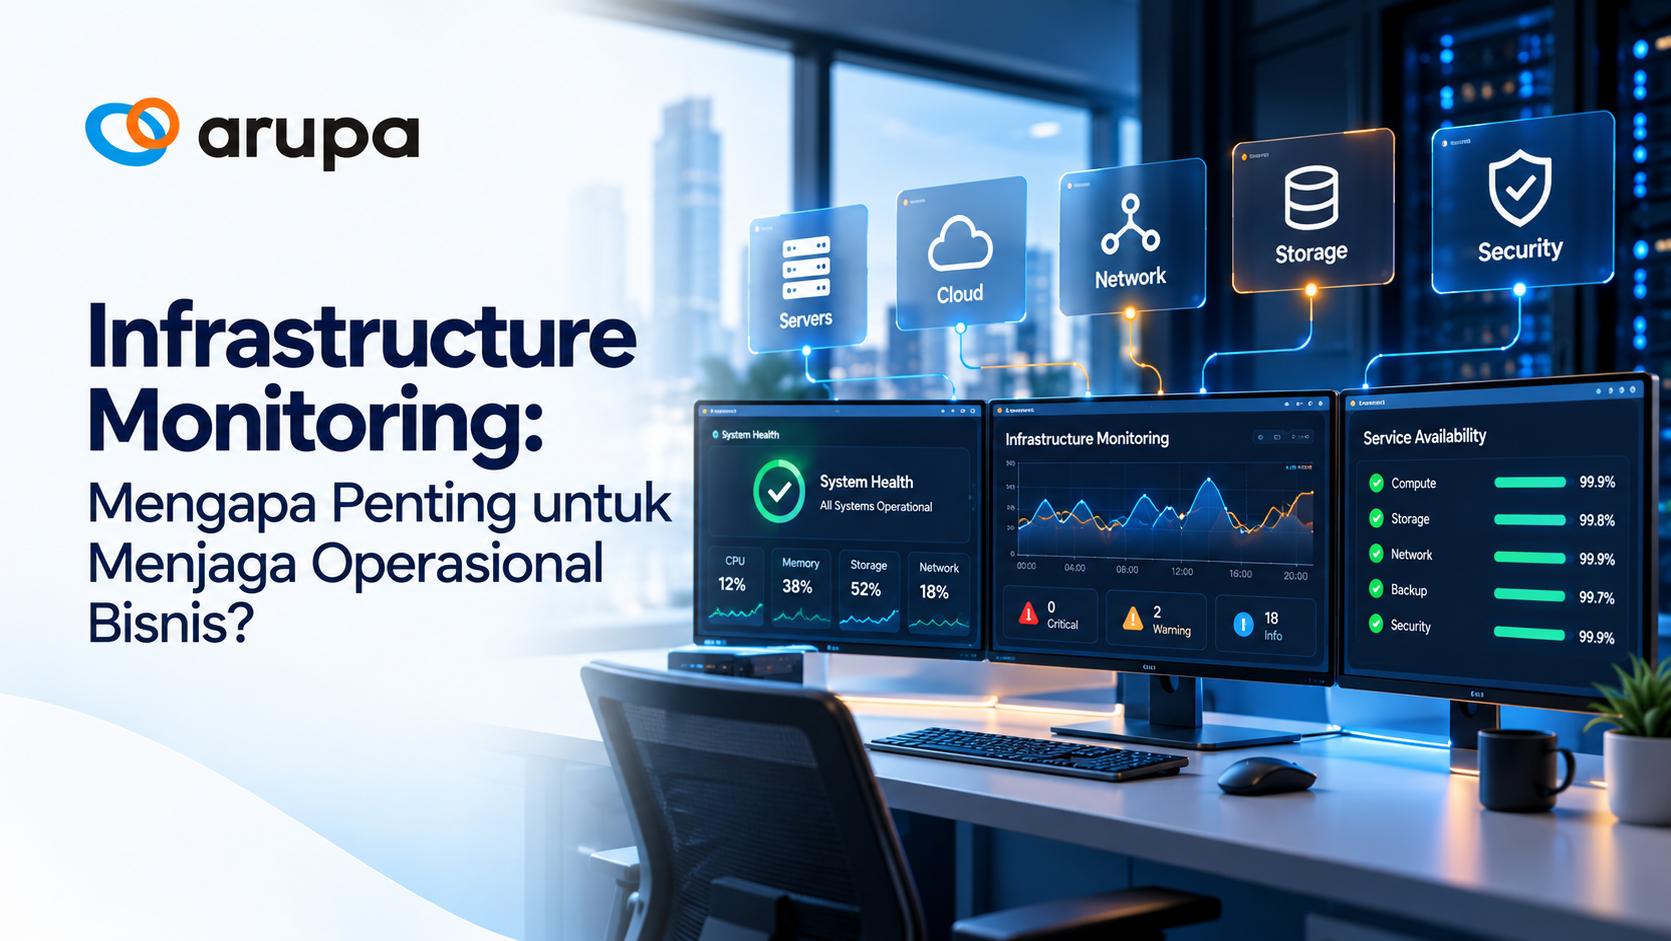
Banyak tim IT baru menyadari pentingnya infrastructure monitoring setelah terjadi gangguan besar. Misalnya, aplikasi tidak dapat diakses, transaksi gagal, atau pelanggan mulai menyampaikan keluhan.
Padahal, tanda-tanda gangguan sering muncul jauh sebelum sistem mengalami downtime. Penggunaan CPU meningkat, kapasitas memori menipis, atau koneksi jaringan mulai melambat.
Sayangnya, tanpa pemantauan yang tepat, tanda-tanda tersebut dapat terlewat.
Oleh karena itu, infrastructure monitoring menjadi bagian penting dalam menjaga stabilitas operasional bisnis. Pemantauan yang efektif membantu tim IT mendeteksi masalah lebih awal dan menentukan tindakan yang diperlukan.
Selain itu, monitoring memberikan informasi untuk mendukung perencanaan kapasitas, pengelolaan risiko, dan keberlangsungan layanan.
Artikel ini membahas pentingnya infrastructure monitoring, komponen yang perlu dipantau, serta strategi penerapannya. Pembahasan juga mencakup peran Managed Service Arupa dalam mendukung pengelolaan infrastruktur IT perusahaan.
Reactive Operations vs Proactive Operations: Apa Perbedaannya?
Dalam pengelolaan infrastruktur IT, terdapat dua pendekatan utama untuk menangani gangguan, yaitu reactive operations dan proactive operations.
Keduanya memiliki cara kerja yang berbeda. Perbedaan tersebut dapat memengaruhi kecepatan penanganan insiden dan stabilitas layanan.
Reactive Operations: Bertindak Setelah Gangguan Terjadi
Reactive operations adalah pendekatan ketika tim IT mulai bertindak setelah masalah terdeteksi.
Sebagai contoh, pengguna melaporkan aplikasi lambat atau sistem tidak dapat diakses. Setelah menerima laporan, tim IT baru melakukan pemeriksaan.
Pendekatan ini memiliki beberapa karakteristik:
- Gangguan sering diketahui setelah pengguna terdampak.
- Troubleshooting dilakukan ketika layanan sudah bermasalah.
- Tim IT harus menangani insiden dalam tekanan waktu.
- Analisis penyebab utama sering tertunda.
- Waktu untuk pengembangan dan perbaikan sistem menjadi terbatas.
Akibatnya, tim IT dapat menghabiskan sebagian besar waktunya untuk menangani masalah berulang.
Selain itu, gangguan yang terlambat diketahui berpotensi memengaruhi produktivitas dan pengalaman pelanggan.
Proactive Operations: Mendeteksi Masalah Lebih Awal
Sebaliknya, proactive operations berfokus pada upaya mendeteksi dan menangani potensi masalah sebelum berdampak besar.
Pendekatan ini memanfaatkan monitoring untuk mengidentifikasi perubahan performa dan anomali pada sistem.
Beberapa karakteristiknya meliputi:
- Anomali sistem terdeteksi melalui pemantauan metrik.
- Notifikasi dikirim ketika indikator risiko muncul.
- Tim IT dapat melakukan pemeriksaan lebih awal.
- Perencanaan kapasitas dilakukan berdasarkan data historis.
- Proses operasional dapat diperbaiki secara berkelanjutan.
Dengan demikian, perusahaan memiliki kesempatan lebih besar untuk mencegah gangguan berkembang menjadi insiden serius.
Namun, proactive operations tetap membutuhkan proses penanganan insiden yang jelas.
Infrastructure monitoring menjadi salah satu fondasi penting untuk mendukung peralihan dari reactive menuju proactive operations.
Apa Saja yang Perlu Dipantau dalam Infrastructure Monitoring?
Infrastructure monitoring tidak hanya berfokus pada satu server atau aplikasi.
Sebaliknya, pemantauan perlu mencakup berbagai komponen yang mendukung layanan IT perusahaan.
Berikut beberapa komponen utama yang perlu diperhatikan.
1. Server dan Compute
Server merupakan komponen penting dalam menjalankan aplikasi serta layanan bisnis.
Oleh karena itu, performa server perlu dipantau secara berkala.
Beberapa indikator utama meliputi:
- CPU Utilization: Mengukur penggunaan prosesor dan mendeteksi beban berlebihan.
- Memory Usage: Memantau penggunaan memori dan potensi memory leak.
- Disk Usage: Mengawasi kapasitas penyimpanan agar tidak penuh.
- Process Health: Memastikan proses dan layanan penting tetap berjalan.
Sebagai contoh, penggunaan CPU yang terus meningkat dapat menunjukkan adanya perubahan workload.
Namun, penggunaan CPU tinggi tidak selalu berarti terjadi gangguan. Tim IT perlu membandingkannya dengan pola penggunaan normal.
2. Storage
Storage memiliki peran penting dalam menjaga ketersediaan dan performa data.
Karena itu, pemantauan storage perlu mencakup kapasitas, performa, dan kondisi perangkat.
Indikator yang umum digunakan adalah:
- Storage Capacity: Persentase kapasitas yang telah digunakan.
- IOPS: Jumlah operasi baca dan tulis per detik.
- Storage Latency: Waktu respons proses baca dan tulis.
- Device Health: Kondisi storage array, disk, atau RAID controller.
Selain itu, data historis dapat membantu memperkirakan kebutuhan kapasitas pada masa mendatang.
Dengan begitu, perusahaan dapat merencanakan penambahan storage sebelum kapasitas menjadi terbatas.
3. Network
Gangguan jaringan dapat menyebabkan aplikasi lambat meskipun server masih berjalan normal.
Oleh sebab itu, network monitoring harus menjadi bagian dari strategi pemantauan infrastruktur.
Beberapa metrik yang perlu diperhatikan:
- Bandwidth Utilization: Tingkat penggunaan kapasitas jaringan.
- Network Latency: Waktu yang dibutuhkan data untuk mencapai tujuan.
- Packet Loss: Persentase paket data yang gagal terkirim.
- Device Health: Kondisi switch, router, dan firewall.
Sebagai contoh, packet loss yang meningkat dapat mengganggu komunikasi antarsistem.
Oleh karena itu, tim IT perlu memantau konektivitas dan kualitas jaringan secara konsisten.
4. Aplikasi dan Service
Selain infrastruktur, performa aplikasi juga perlu dipantau.
Hal ini penting karena server yang aktif belum tentu menunjukkan bahwa aplikasi berjalan dengan baik.
Beberapa indikator aplikasi meliputi:
- Response Time: Waktu yang dibutuhkan aplikasi untuk merespons permintaan.
- Error Rate: Persentase permintaan yang mengalami kegagalan.
- Transaction Success Rate: Persentase transaksi yang berhasil diproses.
Sebagai contoh, aplikasi mungkin masih dapat diakses meskipun sebagian transaksi gagal.
Dengan application monitoring, perusahaan dapat mengidentifikasi masalah tersebut lebih cepat.
5. Service Availability dan SLA
Ketersediaan layanan merupakan indikator penting bagi operasional bisnis.
Karena itu, perusahaan perlu memantau apakah layanan memenuhi target yang telah ditetapkan.
Indikator yang digunakan meliputi:
- Uptime: Persentase waktu layanan tersedia.
- SLA Compliance: Kesesuaian performa layanan dengan perjanjian yang berlaku.
Selain itu, pemantauan historis membantu perusahaan mengidentifikasi periode gangguan.
Data tersebut dapat digunakan untuk evaluasi layanan dan peningkatan kualitas operasional.
Empat Pilar Penting dalam Infrastructure Monitoring
Monitoring yang efektif membutuhkan lebih dari sekadar alat pemantauan.
Terdapat empat komponen utama yang saling mendukung, yaitu metrics, logs, alerts, dan dashboards.
Masing-masing memiliki fungsi berbeda dalam membantu tim IT memahami kondisi sistem.
1. Metrics: Mengukur Kondisi Infrastruktur
Metrics merupakan data numerik yang menunjukkan performa sistem.
Contohnya adalah penggunaan CPU, konsumsi memori, network throughput, dan response time.
Data tersebut biasanya dikumpulkan secara berkala dan disimpan untuk analisis historis.
Agar bermanfaat, metrics sebaiknya memiliki beberapa karakteristik:
- Relevan dengan kebutuhan operasional bisnis.
- Memiliki baseline atau nilai acuan yang jelas.
- Dapat digunakan untuk melihat tren performa.
- Mendukung perencanaan kapasitas.
Sebagai contoh, peningkatan memory usage secara bertahap dapat menjadi indikasi masalah.
Dengan memanfaatkan data historis, tim IT dapat memeriksa tren tersebut sebelum terjadi gangguan.
2. Logs: Membantu Investigasi Masalah
Logs merupakan catatan aktivitas atau peristiwa yang dihasilkan sistem.
Data ini dapat berisi pesan kesalahan, aktivitas aplikasi, atau informasi dari perangkat jaringan.
Berbeda dengan metrics, logs memberikan konteks yang lebih detail mengenai kejadian tertentu.
Sebagai contoh, metrics menunjukkan peningkatan error rate pada aplikasi.
Sementara itu, logs dapat membantu menjelaskan kesalahan yang terjadi ketika permintaan diproses.
Oleh karena itu, integrasi metrics dan logs membantu mempercepat troubleshooting.
3. Alerts: Memberikan Peringatan
Alerts merupakan notifikasi yang muncul ketika sistem memenuhi kondisi tertentu.
Misalnya, penggunaan storage mendekati kapasitas maksimum atau aplikasi tidak merespons.
Namun, tidak semua alert memiliki tingkat kepentingan yang sama.
Agar efektif, sistem alerting perlu memperhatikan:
- Actionable: Setiap alert memiliki tindakan yang jelas.
- Severity: Tingkat prioritas sesuai dampak masalah.
- Timing: Notifikasi muncul pada waktu yang tepat.
- Routing: Alert dikirim kepada tim yang bertanggung jawab.
Selain itu, pengaturan alert perlu dievaluasi secara berkala.
Dengan demikian, tim IT dapat mengurangi notifikasi yang tidak diperlukan.
4. Dashboards: Menyediakan Visibilitas
Dashboard menampilkan informasi monitoring dalam bentuk visual yang lebih mudah dipahami.
Melalui dashboard, tim IT dapat melihat status sistem dan indikator performa.
Namun, kebutuhan informasi setiap pengguna dapat berbeda.
Sebagai contoh, tim IT Operations membutuhkan detail teknis. Sementara itu, manajemen lebih membutuhkan informasi mengenai availability dan SLA.
Oleh karena itu, dashboard sebaiknya disesuaikan dengan kebutuhan penggunanya.
Dashboard yang efektif juga harus mudah dibaca dan menampilkan informasi yang relevan.
Threshold dan Trend Analysis dalam Infrastructure Monitoring
Salah satu tantangan monitoring adalah menentukan kapan suatu kondisi dianggap bermasalah.
Untuk menjawabnya, perusahaan dapat menggunakan threshold atau nilai ambang batas.
Threshold membantu menentukan kapan sistem perlu mengirimkan peringatan.
Namun, nilai yang terlalu sensitif dapat menghasilkan banyak false positive.
Sebaliknya, threshold yang terlalu longgar dapat menyebabkan gangguan terlambat terdeteksi.
Cara Menentukan Threshold yang Efektif
Beberapa pendekatan yang dapat digunakan meliputi:
1. Gunakan data historis
Periksa pola penggunaan resource pada periode sebelumnya.
Sebagai contoh, bandingkan aktivitas pada jam kerja dan di luar jam operasional.
2. Pertimbangkan dampak terhadap bisnis
Sistem yang menangani transaksi penting mungkin membutuhkan pengawasan lebih ketat.
Sementara itu, sistem pendukung internal dapat memiliki prioritas berbeda.
3. Gunakan time window
Hindari membuat alert hanya berdasarkan peningkatan sesaat.
Sebagai contoh, penggunaan CPU di atas 90% selama beberapa menit dapat menjadi kondisi yang perlu diperiksa.
4. Lakukan evaluasi berkala
Threshold yang sesuai hari ini belum tentu relevan setelah terjadi perubahan workload.
Oleh karena itu, pengaturan perlu ditinjau berdasarkan kondisi terbaru.
Menggunakan Trend Analysis dan Anomaly Detection
Selain threshold, perusahaan dapat memanfaatkan trend analysis untuk mengenali perubahan performa.
Sebagai contoh, konsumsi memori mungkin meningkat secara konsisten selama beberapa minggu.
Meskipun belum melewati threshold, pola tersebut tetap perlu diperhatikan.
Sementara itu, anomaly detection membantu mengidentifikasi kondisi yang menyimpang dari pola normal.
Dengan kombinasi ini, tim IT dapat memperoleh peringatan yang lebih kontekstual.
Namun, hasil deteksi tetap perlu divalidasi agar tidak menimbulkan tindakan yang tidak diperlukan.
Monitoring vs Observability: Apa Perbedaannya?
Istilah monitoring dan observability sering digunakan dalam pembahasan operasional IT modern.
Keduanya berkaitan dengan pemahaman terhadap kondisi sistem, tetapi memiliki fokus yang berbeda.
Monitoring untuk Mendeteksi Masalah
Monitoring digunakan untuk memantau indikator yang telah ditentukan.
Sebagai contoh, sistem mengirimkan alert ketika penggunaan storage melewati batas tertentu.
Pendekatan ini membantu menjawab pertanyaan:
Apakah sistem berjalan sesuai kondisi yang diharapkan?
Karena itu, monitoring sangat berguna untuk mendeteksi masalah yang sudah memiliki indikator jelas.
Observability untuk Memahami Penyebab Masalah
Observability membantu tim IT memahami perilaku sistem melalui data yang tersedia.
Data tersebut dapat mencakup metrics, logs, dan traces.
Sebagai contoh, sebuah aplikasi mengalami peningkatan response time hanya pada layanan tertentu.
Melalui observability, tim IT dapat menelusuri hubungan antarkomponen untuk menemukan kemungkinan penyebab.
Dengan demikian, observability mendukung investigasi yang lebih mendalam.
Apakah Monitoring dan Observability Harus Digunakan Bersama?
Monitoring dan observability bukan pendekatan yang saling menggantikan.
Sebaliknya, keduanya dapat saling melengkapi.
Monitoring membantu mendeteksi masalah lebih awal. Sementara itu, observability membantu menjelaskan penyebab dan hubungan antarkomponen.
Bagi perusahaan yang baru membangun sistem pemantauan, monitoring dapat menjadi prioritas awal.
Selanjutnya, kemampuan observability dapat dikembangkan sesuai kompleksitas infrastruktur.
Pendekatan ini sangat relevan bagi organisasi yang menggunakan hybrid cloud, microservices, atau distributed systems.
Alert Fatigue: Tantangan dalam Pengelolaan Monitoring
Sistem monitoring yang memiliki terlalu banyak alert belum tentu lebih efektif.
Sebaliknya, jumlah notifikasi yang berlebihan dapat mengurangi kemampuan tim IT dalam merespons insiden.
Kondisi ini dikenal sebagai alert fatigue.
Alert fatigue terjadi ketika tim menerima terlalu banyak peringatan, termasuk notifikasi yang tidak membutuhkan tindakan.
Akibatnya, alert penting berisiko terlewat.
Penyebab Alert Fatigue
Beberapa penyebab yang umum ditemukan meliputi:
- Threshold yang terlalu sensitif.
- Banyak notifikasi yang tidak membutuhkan tindakan.
- Alert duplikat dari satu insiden.
- Pengaturan alert yang tidak diperbarui.
- Routing notifikasi yang kurang tepat.
Sebagai contoh, gangguan database dapat memicu puluhan alert dari aplikasi yang bergantung padanya.
Padahal, semua notifikasi tersebut mungkin berasal dari satu penyebab utama.
Dampak Alert Fatigue terhadap Operasional
Alert fatigue dapat menimbulkan beberapa risiko.
Pertama, tim IT mungkin mulai mengabaikan notifikasi karena terlalu sering menerima peringatan.
Selain itu, banyaknya alert dapat meningkatkan beban kerja engineer yang bertugas.
Akibatnya, waktu penanganan insiden penting berpotensi menjadi lebih lama.
Oleh karena itu, perusahaan perlu memastikan kualitas alert, bukan sekadar jumlahnya.
Cara Mengurangi Alert Fatigue
Beberapa praktik yang dapat diterapkan adalah:
1. Audit alert secara berkala
Evaluasi notifikasi yang muncul untuk menentukan relevansi dan tindakan yang diperlukan.
2. Sesuaikan threshold
Gunakan nilai ambang batas berdasarkan pola penggunaan dan dampak bisnis.
3. Kelompokkan alert terkait
Gabungkan notifikasi yang berasal dari insiden yang sama.
4. Terapkan routing berdasarkan severity
Pastikan alert kritis diterima oleh tim yang dapat menanganinya.
5. Evaluasi efektivitas alert
Gunakan indikator seperti false positive rate dan waktu triage untuk mendukung perbaikan.
Dengan langkah tersebut, sistem monitoring dapat menghasilkan notifikasi yang lebih relevan.
Selain itu, tim IT dapat memusatkan perhatian pada masalah yang membutuhkan tindakan nyata.
Peran Infrastructure Monitoring dalam Capacity Planning dan SLA
Infrastructure monitoring tidak hanya digunakan untuk menangani gangguan.
Data monitoring juga dapat mendukung perencanaan infrastruktur dan evaluasi layanan.
Berikut tiga area utama yang mendapatkan manfaat.
1. Capacity Planning
Capacity planning membantu perusahaan memperkirakan kebutuhan resource pada masa mendatang.
Dengan data monitoring, tim IT dapat memahami pertumbuhan penggunaan CPU, memori, storage, dan jaringan.
Informasi ini membantu perusahaan menentukan kapan kapasitas perlu ditambah.
Sebagai contoh, tren pertumbuhan storage dapat digunakan untuk memperkirakan kebutuhan ekspansi.
Dengan demikian, penambahan kapasitas dapat direncanakan sebelum terjadi keterbatasan resource.
2. SLA Management
Service Level Agreement atau SLA menetapkan target layanan yang perlu dipenuhi.
Infrastructure monitoring membantu menyediakan data untuk mengevaluasi pencapaian target tersebut.
Beberapa indikator yang dapat digunakan adalah uptime, response time, dan durasi gangguan.
Selain itu, data historis dapat membantu mengidentifikasi penyebab ketidaksesuaian SLA.
Oleh karena itu, evaluasi performa layanan dapat dilakukan berdasarkan informasi yang terukur.
3. Business Continuity
Business continuity bertujuan menjaga keberlangsungan aktivitas bisnis ketika terjadi gangguan.
Dalam konteks ini, monitoring membantu perusahaan memperoleh visibilitas terhadap kondisi infrastruktur.
Pemantauan juga sebaiknya mencakup sistem backup, replication, dan disaster recovery.
Sebagai contoh, perusahaan perlu mengetahui ketika proses backup gagal atau replikasi mengalami keterlambatan.
Dengan monitoring yang tepat, kondisi tersebut dapat diketahui lebih awal.
Namun, monitoring tetap perlu didukung prosedur pemulihan, pengujian berkala, dan perencanaan keberlangsungan bisnis.
Peran Monitoring Services dan Managed Cloud
Tidak semua perusahaan memiliki sumber daya untuk mengelola monitoring secara mandiri.
Terlebih lagi, lingkungan hybrid cloud dan multi-cloud dapat meningkatkan kompleksitas operasional.
Oleh karena itu, monitoring services dan managed cloud dapat menjadi pilihan untuk mendukung tim internal.
Manfaat Menggunakan Monitoring Services
Layanan monitoring yang dikelola dapat memberikan beberapa manfaat:
- Pemantauan infrastruktur secara berkelanjutan sesuai cakupan layanan.
- Pengelolaan alert berdasarkan prosedur yang ditentukan.
- Eskalasi insiden kepada pihak yang bertanggung jawab.
- Dashboard dan laporan kondisi infrastruktur.
- Dukungan troubleshooting serta evaluasi performa.
Selain itu, perusahaan dapat memanfaatkan pengalaman penyedia layanan dalam mengelola berbagai lingkungan IT.
Dengan pendekatan tersebut, tim internal memiliki lebih banyak waktu untuk fokus pada kebutuhan bisnis.
Bagaimana Managed Service Arupa Membantu Perusahaan?
Arupa Cloud Nusantara menyediakan solusi Managed Service untuk mendukung pengelolaan infrastruktur IT perusahaan.
Melalui pendekatan managed service, perusahaan dapat memperoleh dukungan operasional sesuai ruang lingkup layanan yang disepakati.
Dukungan tersebut dapat mencakup pemantauan infrastruktur, penanganan alert, dan eskalasi masalah.
Selain itu, pendekatan ini membantu perusahaan membangun proses operasional yang lebih terstruktur.
Bagi organisasi yang mengelola lingkungan hybrid cloud, konsistensi monitoring menjadi semakin penting.
Oleh karena itu, strategi monitoring perlu dirancang berdasarkan arsitektur, tingkat kritikalitas sistem, dan kebutuhan bisnis.
Kapan Perusahaan Perlu Mengevaluasi Sistem Monitoring?
Sistem monitoring perlu dievaluasi secara berkala untuk memastikan efektivitasnya.
Namun, ada beberapa kondisi yang menunjukkan bahwa strategi monitoring perlu mendapat perhatian lebih lanjut.
Tanda Monitoring Belum Berjalan Efektif
Beberapa indikator yang perlu diperhatikan meliputi:
- Gangguan baru diketahui setelah pengguna melapor.
- Tim IT terlalu sering menangani insiden mendadak.
- Banyak alert diabaikan karena dianggap tidak relevan.
- Data historis tidak cukup untuk capacity planning.
- Dashboard tidak menunjukkan kondisi layanan secara menyeluruh.
- Manajemen kesulitan memperoleh informasi availability dan SLA.
Jika kondisi tersebut sering terjadi, perusahaan perlu meninjau kembali pengaturan monitoring.
Langkah Awal Evaluasi Monitoring
Evaluasi dapat dimulai dengan memetakan sistem dan aplikasi yang paling penting bagi bisnis.
Selanjutnya, tentukan metrik yang relevan untuk setiap sistem.
Perusahaan juga perlu memeriksa apakah alert sudah memiliki prioritas dan prosedur penanganan yang jelas.
Selain itu, pastikan data historis tersedia untuk mendukung analisis dan perencanaan.
Dengan langkah tersebut, organisasi dapat memperbaiki sistem monitoring secara bertahap.
Kesimpulan
Infrastructure monitoring merupakan bagian penting dalam menjaga stabilitas dan keberlangsungan operasional bisnis.
Melalui pemantauan yang efektif, perusahaan dapat mendeteksi potensi gangguan, mengevaluasi performa, dan merencanakan kebutuhan infrastruktur.
Selain itu, monitoring membantu tim IT beralih dari pendekatan reactive menuju proactive operations.
Namun, implementasi monitoring tidak cukup hanya dengan memasang tools.
Perusahaan juga membutuhkan metrik yang relevan, pengaturan alert yang tepat, dan proses incident management yang jelas.
Oleh karena itu, strategi monitoring perlu disesuaikan dengan kebutuhan bisnis dan kompleksitas infrastruktur.
Bagi perusahaan yang membutuhkan dukungan pengelolaan infrastruktur, Arupa Managed Service dapat menjadi salah satu solusi yang dipertimbangkan.
Konsultasikan kebutuhan Infrastructure Monitoring dan Managed Service perusahaan Anda bersama tim Arupa.
FAQ
1. Apa perbedaan reactive operations dan proactive operations?
Reactive operations menangani masalah setelah gangguan terjadi. Sebaliknya, proactive operations berupaya mendeteksi masalah lebih awal. Infrastructure monitoring membantu mendukung pendekatan proactive melalui pemantauan metrik dan alert.
2. Komponen apa saja yang perlu dipantau dalam infrastruktur IT?
Komponen utama meliputi server, storage, network, aplikasi, dan service availability. Selain itu, perusahaan perlu memantau performa historis untuk mendukung capacity planning.
3. Apa perbedaan monitoring dan observability?
Monitoring membantu mendeteksi kondisi yang tidak sesuai dengan indikator yang ditentukan. Sementara itu, observability membantu investigasi lebih mendalam melalui metrics, logs, dan traces.
4. Mengapa alert fatigue menjadi masalah?
Alert fatigue terjadi ketika tim IT menerima terlalu banyak notifikasi. Akibatnya, alert penting dapat terlewat. Oleh karena itu, pengaturan alert perlu dievaluasi secara berkala.
5. Bagaimana cara mengurangi alert fatigue?
Perusahaan dapat meninjau threshold, mengelompokkan alert, dan menerapkan routing berdasarkan tingkat prioritas. Selain itu, efektivitas notifikasi perlu dievaluasi melalui data operasional.
6. Apa manfaat monitoring untuk capacity planning dan SLA?
Monitoring menyediakan data penggunaan resource dan performa layanan. Dengan demikian, perusahaan dapat merencanakan kapasitas serta mengevaluasi pencapaian SLA berdasarkan data historis.
7. Kapan perusahaan membutuhkan monitoring services atau managed cloud?
Layanan ini dapat dipertimbangkan ketika pengelolaan infrastruktur semakin kompleks. Selain itu, layanan tersebut relevan jika tim internal membutuhkan dukungan operasional dan pemantauan berkelanjutan.