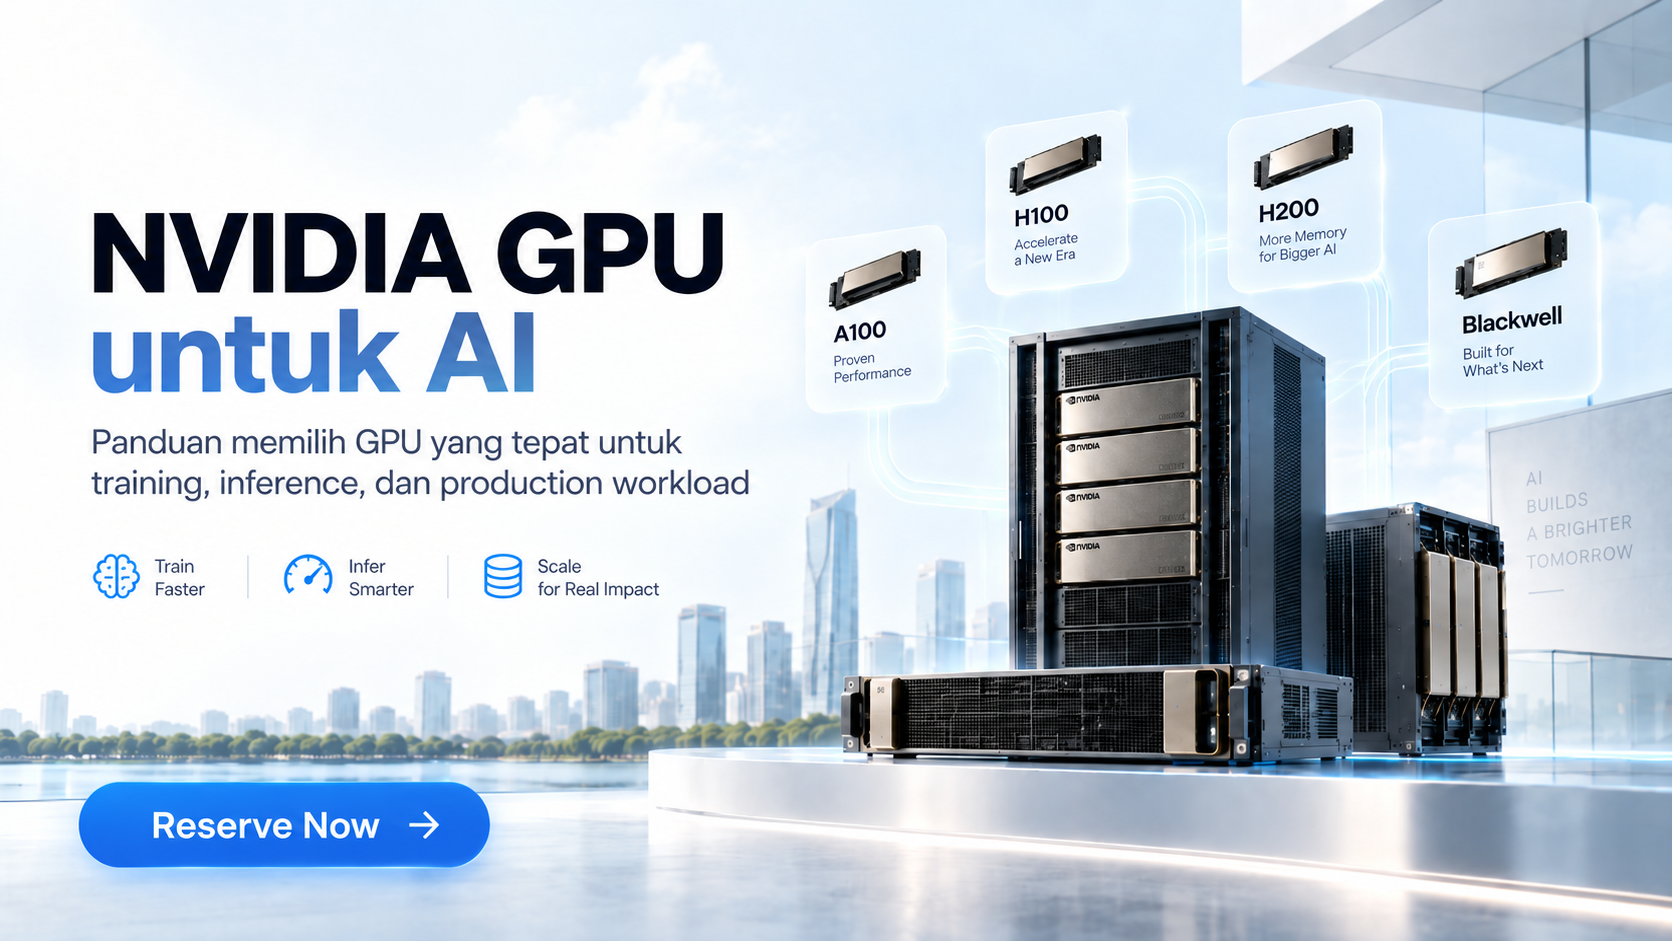
A100, L40S, H100, H200, B200, RTX PRO 6000 Blackwell hingga B300.
Pilihan NVIDIA GPU untuk AI semakin banyak. Melihat spesifikasinya, mudah menyimpulkan bahwa GPU generasi terbaru pasti menjadi pilihan terbaik.
Dalam praktiknya, belum tentu.
Enterprise chatbot dengan traffic terbatas memiliki kebutuhan berbeda dengan large-scale LLM inference. Computer vision berbeda dengan model training. Demikian pula AI development berbeda dengan production service yang melayani ratusan concurrent requests.
Karena itu, memilih GPU sebaiknya dimulai dari workload bukan sekadar memilih GPU dengan spesifikasi tertinggi.
Parameter Apa yang Paling Penting?
Sebelum membandingkan GPU, ada beberapa informasi yang perlu diketahui.
Model dan ukuran model. Semakin besar model, semakin besar pula kebutuhan memory dan compute.
Training atau inference. Training biasanya membutuhkan compute intensif, sementara production inference lebih sensitif terhadap latency, throughput, concurrency, dan cost per request.
GPU memory. Model, KV cache, activations, batching, dan context membutuhkan memory. Karena itu, VRAM sering menjadi faktor pembatas sebelum compute performance.
Concurrency. Model yang berjalan cepat untuk satu user belum tentu memberikan performa sama ketika digunakan banyak user secara bersamaan.
Biaya per workload. Harga per GPU/hour bukan satu-satunya metric. GPU yang lebih cepat dapat menghasilkan cost per request atau cost per job yang berbeda.
Setelah parameter tersebut diketahui, barulah perbandingan GPU menjadi lebih relevan.
A100: GPU Serbaguna untuk AI dan Data
NVIDIA A100 masih menjadi pilihan yang relevan untuk banyak workload AI.
Civo menyediakan A100 dengan pilihan 40 GB dan 80 GB dan memosisikannya untuk AI, machine learning, data analytics, scientific computing, training dan inference. (Civo)
A100 menarik ketika perusahaan membutuhkan GPU yang mature dan fleksibel tanpa harus langsung menggunakan generasi GPU tertinggi.
Cocok dipertimbangkan untuk:
AI/ML development, model training, inference, analytics dan scientific computing.
L40S: AI Bertemu Visual Computing
Tidak semua AI workload berfokus pada LLM.
Computer vision, rendering, video processing dan visualization memiliki karakter berbeda.
NVIDIA L40S menyediakan 48 GB GPU memory dan Civo mengarahkannya untuk inference, graphics, rendering, streaming serta kombinasi AI dan visual computing. (Civo)
Cocok dipertimbangkan untuk:
computer vision, rendering, video processing, visual AI dan inference.
H100: Untuk Intensive AI dan LLM
H100 menjadi salah satu GPU yang banyak diasosiasikan dengan perkembangan generative AI.
Civo menawarkan H100 80 GB untuk workload seperti LLM, computer vision, generative modelling serta intensive AI training. (Civo)
H100 mulai menarik ketika perusahaan membutuhkan compute yang lebih tinggi untuk training maupun high-throughput inference.
Cocok dipertimbangkan untuk:
LLM, generative AI, training, computer vision dan production inference.
H200: Ketika Memory Menjadi Faktor Penting
Pada model yang semakin besar, masalahnya tidak selalu kekurangan compute.
Sering kali kendalanya adalah memory.
H200 menyediakan memory lebih besar dibanding H100. Portfolio Civo mencantumkan H200 untuk large LLM, HPC dan memory-intensive AI workloads. (Civo)
Ini membuatnya relevan ketika model, context, atau inference workload membutuhkan kapasitas memory yang lebih tinggi.
Cocok dipertimbangkan untuk:
large LLM, high-memory inference, generative AI dan HPC.
B200: Blackwell untuk AI Berskala Tinggi
NVIDIA B200 menggunakan arsitektur Blackwell dan berada pada kelas workload yang lebih tinggi.
Civo menempatkan B200 untuk data center-scale generative AI, large-model training dan high-throughput production inference. (Civo)
B200 menjadi menarik ketika perusahaan sudah menghadapi model atau traffic yang mulai melampaui kelas GPU sebelumnya.
Namun menggunakan B200 untuk workload kecil belum tentu menghasilkan ekonomi terbaik.
Cocok dipertimbangkan untuk:
large-scale GenAI, frontier inference, large model training dan high-throughput AI.
RTX PRO 6000 Blackwell: AI dan Visual Workload
RTX PRO 6000 Blackwell Server Edition memiliki positioning yang sedikit berbeda.
Arupa mencantumkan GPU ini dengan 96 GB GDDR7 ECC memory untuk enterprise inference, multimodal AI, visual computing, rendering dan simulation. RTX PRO 6000 direncanakan menjadi salah satu upcoming GPU di Civo Region Jakarta. (Arupa Cloud Nusantara)
Kombinasi AI compute dan graphics membuatnya menarik untuk perusahaan yang workload-nya tidak hanya berfokus pada LLM.
Cocok dipertimbangkan untuk:
enterprise inference, multimodal AI, computer vision, rendering, simulation dan visual computing.
B300: Untuk Frontier dan Next-Generation AI
B300 Blackwell Ultra berada di kelas workload AI yang jauh lebih besar.
Civo memosisikan B300 untuk demanding inference, agentic AI dan large-scale generative AI. Portfolio Civo saat ini mencatat B300 sebagai bagian dari jajaran GPU generasi Blackwell Ultra. (Civo)
Arupa juga mencantumkan B300 sebagai upcoming di Civo Region Jakarta, terutama untuk frontier AI, agentic AI dan high-scale production inference. (Arupa Cloud Nusantara)
Cocok dipertimbangkan untuk:
reasoning models, agentic AI, frontier LLM, large-scale inference dan next-generation AI platform.
Ringkasnya, GPU Mana yang Cocok?
| GPU | Karakter workload |
| A100 | AI/ML serbaguna, training, inference, analytics |
| L40S | Visual AI, inference, rendering, graphics |
| H100 | LLM, GenAI, computer vision, intensive training |
| H200 | Large LLM dan memory-intensive workloads |
| B200 | Large-scale GenAI dan frontier inference |
| RTX PRO 6000 Blackwell | Development, Enterprise AI + visual computing |
| B300 | Agentic AI, reasoning dan frontier-scale workloads |
Tabel ini sebaiknya digunakan sebagai starting point, bukan keputusan akhir.
GPU yang tepat tetap bergantung pada model, precision, context, concurrency, target performance, dan biaya.
GPU Compute atau Kubernetes?
Pilihan GPU hanyalah satu bagian dari infrastructure AI.
Untuk PoC, development atau single-model deployment, GPU Compute sering menjadi pilihan paling sederhana.
Ketika workload berkembang menjadi multiple models, APIs, inference services, MLOps dan microservices, Kubernetes menjadi lebih relevan.
Civo mendukung kedua pendekatan tersebut: traditional GPU Compute dan GPU Kubernetes. (Civo)
Artinya, perusahaan dapat memulai sederhana lalu mengembangkan architecture ketika aplikasi mulai membutuhkan scale dan orchestration.
Jangan Membandingkan Harga GPU per Jam Saja
Ini salah satu kesalahan paling umum.
Misalnya GPU A lebih murah per jam, tetapi membutuhkan waktu tiga kali lebih lama untuk menyelesaikan workload dibanding GPU B.
GPU mana yang sebenarnya lebih murah?
Pertanyaan serupa berlaku untuk inference. GPU dengan hourly cost lebih tinggi mungkin mampu memproses concurrency lebih besar sehingga cost per request justru lebih efisien.
Karena itu, benchmark yang lebih berguna adalah:
cost per workload,
cost per request,
atau cost untuk mencapai target performance.
Bukan sekadar harga GPU per jam.
Mulai dengan Benchmark Workload Anda
Tidak ada satu NVIDIA GPU yang menjadi pilihan terbaik untuk semua AI workload.
A100 tetap relevan untuk banyak kebutuhan. L40S punya posisi kuat untuk AI dan graphics. H100 cocok untuk intensive AI, sementara H200 menawarkan memory lebih besar. B200 dan B300 membawa kemampuan Blackwell untuk workload yang semakin besar. RTX PRO 6000 Blackwell membuka opsi menarik untuk enterprise AI dan visual computing.
Jadi sebelum memilih GPU, lakukan satu hal:
Uji workload nyata Anda.
Temukan GPU yang Tepat untuk AI Anda
Jika perusahaan Anda sedang mengevaluasi NVIDIA GPU Cloud di Indonesia, tim Arupa dapat membantu memetakan model, GPU memory, concurrency, target latency, deployment model, dan kebutuhan lokasi data sebelum menentukan GPU untuk PoC maupun production.
FAQ
GPU apa yang cocok untuk LLM?
Tergantung ukuran model, precision, quantization, context length dan concurrency. H100, H200, B200 atau B300 dapat menjadi kandidat untuk workload yang semakin besar, sementara model yang lebih kecil belum tentu membutuhkan GPU kelas tertinggi.
Apa perbedaan utama H100 dan H200?
Salah satu perbedaan penting adalah kapasitas memory. H200 menawarkan memory lebih besar sehingga lebih menarik untuk large model dan memory-intensive inference. (Civo)
Apakah GPU paling baru selalu lebih baik?
Tidak. GPU yang paling efisien adalah GPU yang memenuhi target workload dengan performance dan biaya yang tepat. GPU generasi lebih tinggi dapat menjadi overprovisioned untuk workload yang relatif kecil.