Redundansi adalah penyediaan komponen, kapasitas, atau jalur cadangan agar suatu sistem tetap dapat menjalankan fungsi penting ketika salah satu bagian mengalami gangguan. Dalam infrastruktur IT perusahaan, redundansi bisa diterapkan pada server, jaringan, penyimpanan, sumber listrik, hingga lokasi pusat data.
Bagi bisnis yang mengandalkan ERP, sistem transaksi, atau aplikasi pelanggan, satu titik kegagalan (single point of failure) dapat menghentikan banyak proses sekaligus. Redundansi server membantu mengurangi ketergantungan tersebut—tetapi tetap harus dirancang bersama monitoring, backup, dan disaster recovery.
Apa Itu Redundansi dalam Infrastruktur IT?
Secara teknis, redundansi berarti ada lebih dari satu komponen yang dapat mendukung fungsi yang sama. Jika satu komponen gagal, komponen lain dapat mempertahankan atau memulihkan layanan, sesuai desain sistem dan mekanisme perpindahan (failover).
Contoh paling sederhana adalah dua koneksi internet dari penyedia berbeda. Apabila jalur pertama putus, router dapat mengarahkan koneksi ke jalur kedua jika failover dikonfigurasi dan diuji. Prinsip yang sama berlaku pada server aplikasi, perangkat jaringan, atau lokasi pemrosesan data.
Redundansi bukan berarti semua sistem otomatis bebas gangguan. Jika komponen cadangan memiliki ketergantungan yang sama misalnya berada pada satu rak atau menggunakan sumber listrik yang sama keduanya masih bisa gagal secara bersamaan.
Mengapa Redundansi Penting untuk Perusahaan?
Menjaga ketersediaan aplikasi bisnis
Server yang memiliki jalur cadangan dapat mengurangi dampak kerusakan perangkat terhadap pengguna. Dalam rancangan yang tepat, beban kerja dapat diteruskan atau dipindahkan saat komponen utama tidak tersedia.
Mengurangi single point of failure
Satu router, satu switch, atau satu sumber listrik dapat menjadi titik lemah. Pemetaan ketergantungan membantu tim IT menemukan titik yang harus memiliki alternatif.
Mendukung proses pemeliharaan
Pada arsitektur tertentu, beberapa pekerjaan pembaruan atau perawatan dapat dilakukan bergantian tanpa menghentikan seluruh sistem. Ini tetap membutuhkan prosedur maintenance dan pengujian, bukan hanya duplikasi perangkat.
Memperkuat kesiapan pemulihan
Redundansi memudahkan rancangan high availability dan menjadi salah satu bagian strategi disaster recovery. AWS Well-Architected menekankan desain yang mampu bertahan dari kegagalan komponen, sekaligus kebutuhan menguji pemulihan secara berkala melalui panduan Reliability.
Jenis-Jenis Redundansi yang Umum Digunakan
1. Redundansi server
Aplikasi dijalankan pada lebih dari satu server atau node. Jika salah satu node gagal, node sehat bisa menerima beban kerja melalui mekanisme cluster, load balancer, atau failover. Periksa juga kapasitas node cadangan: sistem dua node belum tentu mampu menampung seluruh beban jika satu node berhenti.
2. Redundansi jaringan
Perusahaan menggunakan lebih dari satu perangkat, jalur, atau koneksi internet. Redundansi jaringan perlu memperhitungkan rute, perangkat inti, dan titik sambung fisik; dua ISP yang melewati satu kabel gedung masih memiliki risiko bersama.
3. Redundansi penyimpanan dan data
Teknologi seperti RAID, replika storage, atau replikasi database dapat membantu mempertahankan akses saat disk atau komponen gagal. Namun replikasi bukan backup historis: kesalahan penghapusan atau enkripsi akibat ransomware dapat ikut tersalin ke replika.
4. Redundansi daya dan lokasi
Sistem UPS, catu daya ganda, dan jalur kelistrikan cadangan mengurangi ketergantungan pada satu sumber daya. Untuk risiko skala lokasi, organisasi dapat mempertimbangkan site cadangan atau distribusi beban ke lokasi yang terpisah secara geografis.
Active-Active dan Active-Passive: Apa Bedanya?
Active-active menjalankan lebih dari satu node atau site secara aktif untuk melayani trafik. Pendekatan ini dapat membantu distribusi beban dan kelangsungan layanan, tetapi membutuhkan desain konsistensi data, routing, dan koordinasi kegagalan yang lebih kompleks.
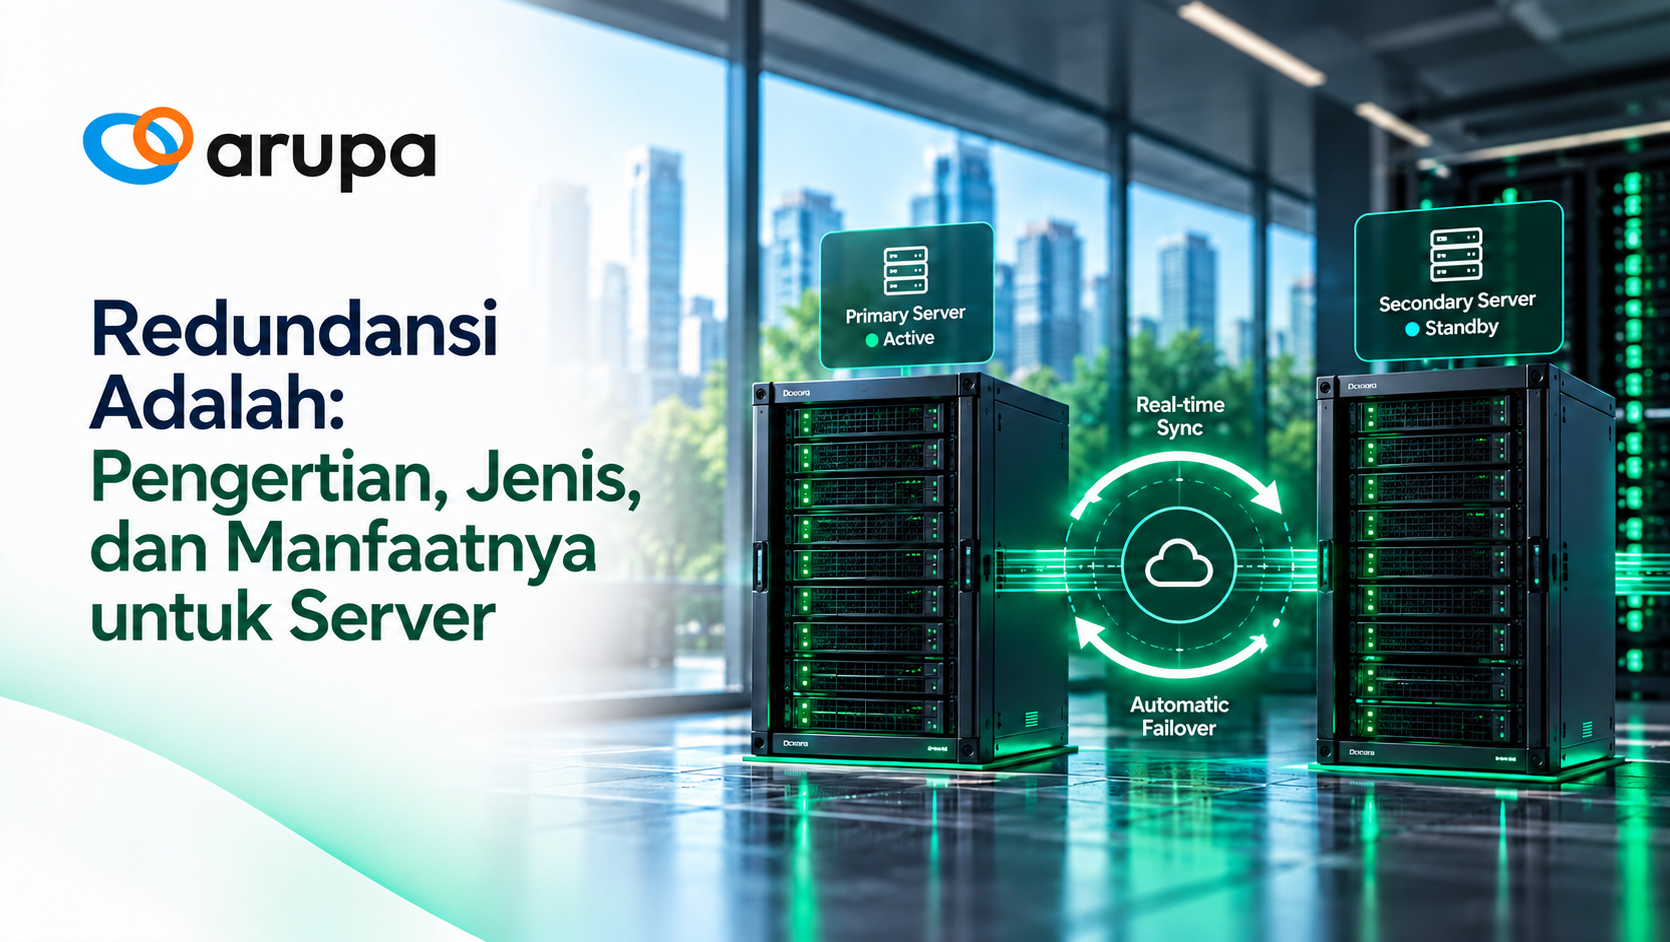
Active-passive menggunakan komponen utama yang aktif, sementara komponen kedua disiapkan sebagai cadangan. Saat kegagalan terdeteksi, beban kerja dipindahkan ke lingkungan pasif melalui prosedur manual atau otomatis, sesuai desain.
Tidak ada model yang selalu lebih baik. Organisasi memilih berdasarkan toleransi gangguan, karakter aplikasi, kompleksitas, serta anggaran. Bahkan pada active-active, gangguan layanan masih mungkin terjadi jika penyebabnya bersifat bersama, seperti kesalahan konfigurasi global atau masalah aplikasi.
Redundansi, Backup, dan Disaster Recovery Tidak Sama
Redundansi bertujuan menjaga ketersediaan saat komponen gagal. Backup menyediakan salinan data yang dapat dipulihkan dari titik waktu tertentu. Disaster recovery mencakup orang, prosedur, aplikasi, konektivitas, dan infrastruktur untuk memulihkan layanan setelah gangguan besar.
Contohnya, database yang direplikasi secara real-time ke server kedua dapat tetap tersedia saat server pertama rusak. Namun jika pengguna tidak sengaja menghapus tabel penting dan penghapusan itu ikut direplikasi, perusahaan membutuhkan backup atau kemampuan pemulihan ke titik waktu sebelumnya. Karena itu, ketiganya saling melengkapi.
Cara Merancang Redundansi Server yang Efektif
Mulai dari kebutuhan bisnis, bukan dari daftar perangkat yang hendak dibeli:
1. Petakan layanan kritikal. Identifikasi aplikasi yang paling berdampak jika berhenti, beserta database, DNS, autentikasi, dan konektivitas pendukungnya.
2. Temukan dependensi tunggal. Periksa host virtualisasi, storage, switch, firewall, daya, hingga penyedia koneksi.
3. Tentukan target pemulihan. Sepakati waktu henti serta kehilangan data yang dapat diterima bersama pemilik proses bisnis.
4. Pisahkan domain kegagalan. Hindari seluruh komponen cadangan bertumpu pada satu rak, sumber listrik, atau lokasi jika risiko tersebut perlu diantisipasi.
5. Siapkan observabilitas. Monitoring kesehatan node, kapasitas cadangan, alert, dan log failover perlu mudah diakses.
6. Uji skenario gagal. Simulasikan pemadaman node atau pemutusan koneksi secara terkendali; catat hasil, masalah, dan tindak lanjut.
Arsitektur Private Cloud Arupa dapat menjadi bahan diskusi untuk pengelolaan infrastruktur dan integrasi model hybrid. Untuk kebutuhan pemulihan yang melibatkan lokasi cadangan, lihat juga solusi Disaster Recovery Arupa.
Contoh Penerapan: Aplikasi ERP di Dua Node
Bayangkan aplikasi ERP berjalan pada dua node virtualisasi dengan penyimpanan dan jalur jaringan yang telah dirancang untuk failover. Ketika satu node mengalami kerusakan perangkat, beban kerja bisa dipindahkan ke node lain. Tim IT kemudian memeriksa layanan database, sesi pengguna, dan performa aplikasi setelah perpindahan.
Contoh ini ilustratif; durasi serta tingkat gangguan akan berbeda pada setiap arsitektur. Uji failover berkala menjadi cara untuk mengetahui apakah rancangan benar-benar bekerja sesuai harapan.
Kesalahan Umum dalam Strategi Redundansi
Kesalahan yang paling sering terjadi adalah menggandakan server, tetapi tidak menggandakan dependensinya. Perusahaan juga kadang melewatkan tes pemulihan, mengabaikan kapasitas node cadangan, atau menganggap replikasi setara dengan backup.
Agar investasi tidak sia-sia, tetapkan owner pengujian, inventaris komponen, dan dokumentasi perubahan. Setelah penambahan aplikasi atau perubahan jaringan, cek kembali apakah rancangan cadangan masih relevan.
Kesimpulan
Redundansi adalah pendekatan penting untuk mengurangi single point of failure dan mendukung ketersediaan server. Namun desain yang efektif membutuhkan pemisahan risiko, kapasitas cadangan, monitoring, serta pengujian failover. Redundansi paling kuat ketika diterapkan bersama backup dan disaster recovery.
Ingin mengevaluasi apakah infrastruktur saat ini masih memiliki titik kegagalan tunggal? Pelajari Private Cloud Arupa dan layanan Disaster Recovery untuk mendiskusikan kebutuhan ketahanan sistem perusahaan.
FAQ
Apakah redundansi sama dengan high availability?
Tidak persis. Redundansi adalah salah satu cara menyediakan komponen cadangan; high availability adalah hasil desain yang bertujuan menjaga layanan tetap tersedia. Redundansi tanpa mekanisme failover yang berfungsi belum tentu menghasilkan ketersediaan tinggi.
Apakah RAID bisa menggantikan backup?
Tidak. RAID dapat membantu menghadapi jenis kegagalan disk tertentu, tetapi tidak melindungi dari seluruh risiko, termasuk penghapusan data secara tidak sengaja atau ransomware.
Apakah semua aplikasi perlu active-active?
Tidak. Aplikasi dengan risiko sedang dapat memakai active-passive atau pemulihan berbasis backup. Pilihan harus mengikuti target bisnis, karakter aplikasi, dan biaya implementasi.